雨晴LLM
类型:系统工具版本:v1.0.0
大小:57.1MB系统:Android更新:2026-09-27 11:24:29
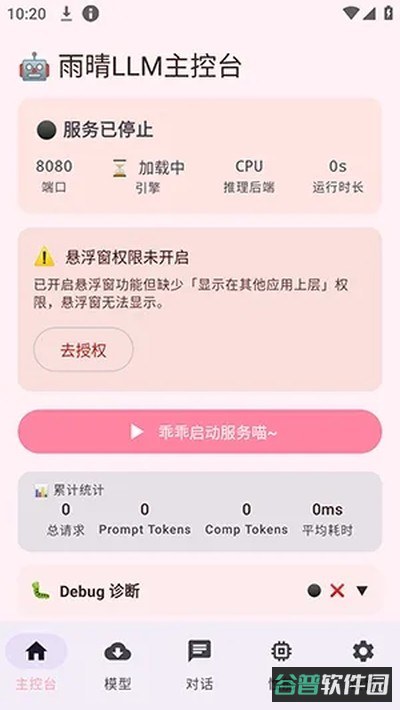
雨晴LLM 把大语言模型搬到了安卓手机本地运行,不需要联网,手机自己就能当一台小型 AI 推理服务器用。文本生成、对话交流这些事,断网状态下照样能跑完,数据从头到尾留在设备里,不上传云端,也就没有隐私外泄的担心,网络卡顿或者突然掉线的问题同样绕开了。装好之后不用折腾代码编译,也不用配什么开发环境,普通安卓机拿来就能加载模型跑起来,本地部署这件事变得没什么门槛。
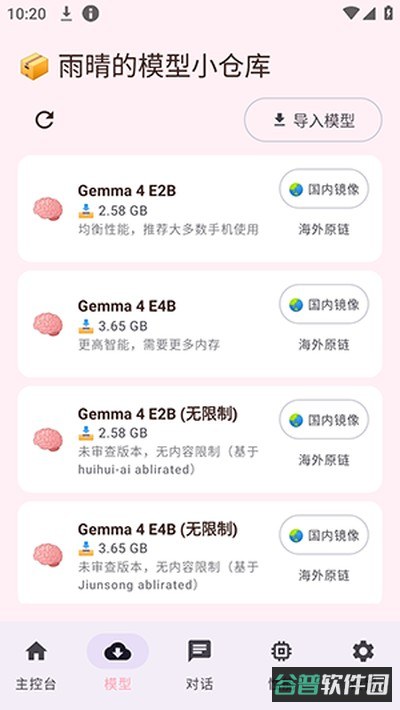
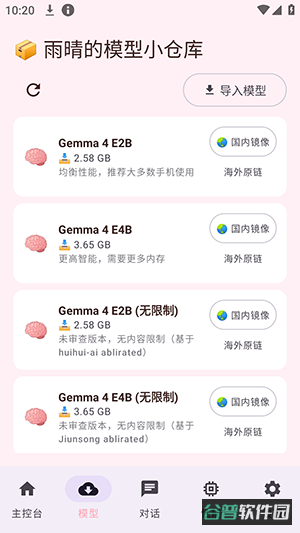
模型文件走的是分离式管理,应用本身不塞体积庞大的模型包,用户按自己手机的存储余量去取对应的 Gemma 量化权重加载就行,空间占用由自己说了算。
它完整适配了标准的 OpenAI 对话交互协议,长文本上下文关联和各项生成参数微调都支持。原来基于云端 API 写的项目,代码基本不用动就能挪到本地跑。
桌面悬浮窗组件可以自由拖曳,不必反复切回主程序界面,在屏幕任意位置就能控制服务启停、换底模或者调出后台日志。
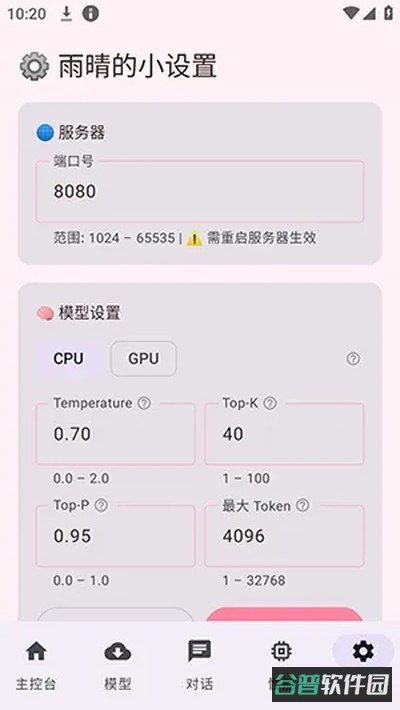
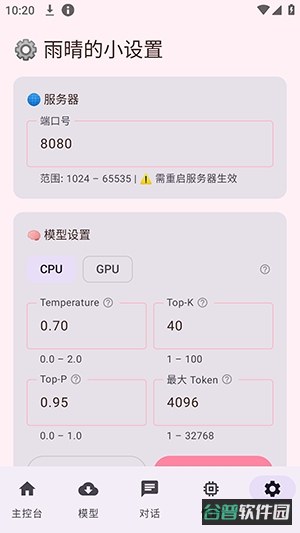
生成控制项给得比较全,采样温度、上下文窗口大小、单次最大输出字数这些都能自己调,日常写点东西、做逻辑分析或者写代码,不同任务可以配不同参数。
1、CPU 和 GPU 两套计算引擎都支持,可以按机型硬件水平和电池功耗表现自己切。老设备求稳,高端芯片想用图形加速,两种需求都照顾到了。
2、底层接了轻量级 NanoHTTPd 服务,在手机本地就能生成标准 OpenAI 格式的接口地址,常见的第三方 AI 聊天软件、自动化脚本、测试工具都能直接对接。
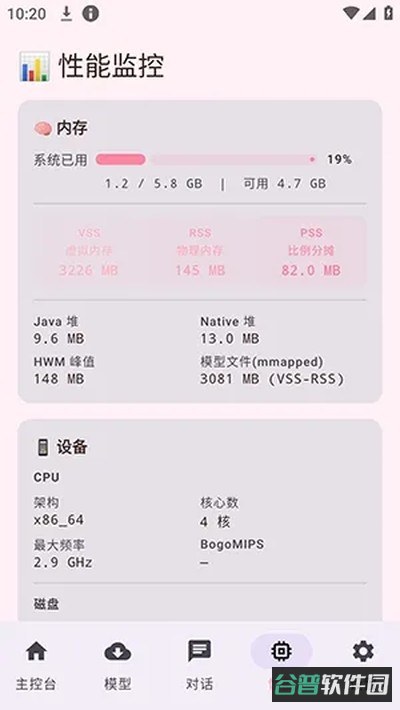
3、自带图形化运行数据监视面板,Token 生成速率、RAM 消耗、处理器负荷都会动态显示出来,系统开销随时能看,参数想微调也有依据。
4、后台常驻能力比较稳,推理服务开着的时候,界面切后台或者锁屏,接口照样响应请求,别的应用调用时不会断。
1、把安装包装好,然后到系统设置里放行读写存储、悬浮窗显示和后台常驻运行这几项权限。
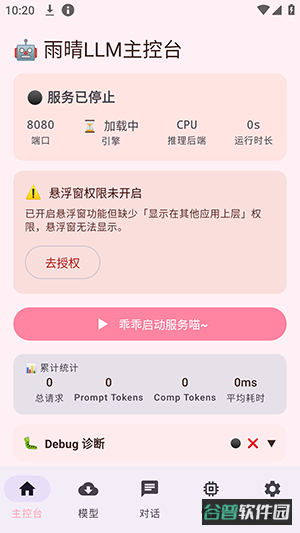
2、进入模型管理区域,挑一个跟当前机型性能匹配的 Gemma 量化权重文件下载下来。
3、选好这次要调用的 CPU 或 GPU 运算后端,点一下开启本地服务接口。
4、在支持 OpenAI 协议的客户端里,把服务端 URL 填成本地回路地址 `//127.0.0.1:8080`,然后发请求。
5、用桌面上的悬浮控制器,可以随时看文字输出进度、换一个加载的模型,或者直接把后台服务关掉。
包名:com.rainyllm.app
MD5:b8eb171b59e93be8fba9214f84783ba6
 jy端口加速器
 v2.0 / 31.4 MB查看
2
 xiconchanger最新版v4.5.2 / 60.83 MB查看
3
 myhorror汤姆猫病毒手机版v3.0 / 2.5 MB查看
4
 HyperCeiler(澎湃os扩展工具)v2.5.152 / 5.5 MB查看
5
 oppo家庭空间app官方版下载(家人守护)v16.5.0 / 67.11 MB查看
6
 kbattery直驱供电v1.0 / 23.99 MB查看
7
 全渠道质检App
 v6.8.0 / 22.09 MB查看
8
 面具alpha最新版V83d837d8安卓版 / 11.31 MB查看
9
 懒洋羊软件库官方正版v3.2.1 / 9.1 MB查看
10
 迅雷hd版最新版v7.48.0.8104 / 90.33 MB查看
 系统工具 / 54.5 MB
 HTTPCANARY
 清楚助放大
 世界盒子工具
 轩隐藏文件
 lk美化包2.6